Besökare som kommer via AI konverterar i upp till 18 % av fallen. Det är ungefär 4–10 gånger högre än för besökare från organisk sök. Ändå står trafik från AI källhänvisningar fortfarande för mindre än 2 % av den totala webbtrafiken. Varumärken som bemästrar LLM seeding redan nu bygger ett försprång som växer över tid, innan konkurrensen hårdnar. I den här guiden fra Weply får du veta hur.
Din konkurrent dök precis upp i ett svar från ChatGPT. Ditt varumärke gjorde det inte. Det är ingen slump. Och det handlar inte om tur. Bakom synligheten ligger en medveten strategi som kallas LLM seeding: att systematiskt bygga ditt varumärkes närvaro på webben så att stora språkmodeller hänvisar till dig när användare ställer frågor som är viktiga för din affär. LLM seeding är en del av din övergripande strategi för Answer Engine Optimization (AEO).
Spelreglerna förändras snabbt. Stora språkmodeller hänvisar bara till 2–7 domäner per svar, jämfört med Googles tio blå länkar och fler resultat längre ned. Konkurrensen om de få platserna blir allt hårdare. När en modell väl har etablerat en källa som trovärdig tenderar den dessutom att återkomma till den i svar på liknande frågor. Det skapar en dynamik där de som tar täten får en oproportionerligt stor del av synligheten. Om ditt varumärke saknas i svaren i dag lär sig användarna att förknippa din kategori med någon annans.
Den här guiden går igenom hur AI-modeller faktiskt väljer vilka källor de hänvisar till, vilka strategier som återkommande leder till omnämnanden, vilka plattformar som väger tyngst och hur du mäter om arbetet ger resultat.
Vad är LLM seeding?
LLM seeding innebär att strategiskt sprida korrekt, trovärdigt och maskinläsbart innehåll på webben så att AI-tjänster som ChatGPT, Claude, Perplexity och Googles AI Overviews inkluderar ditt varumärke i sina svar. Det är en del av det bredare arbetet med Answer Engine Optimization (AEO).
Begreppet består av två delar:
- LLM (Large Language Model): En stor språkmodell – AI-tekniken bakom tjänster som ChatGPT, Claude, Perplexity och Gemini.
- Seeding: Att så frön genom att placera information om ditt varumärke där AI hämtar underlag till sina svar: i träningsdata, trovärdiga webbkällor och på auktoritativa plattformar.
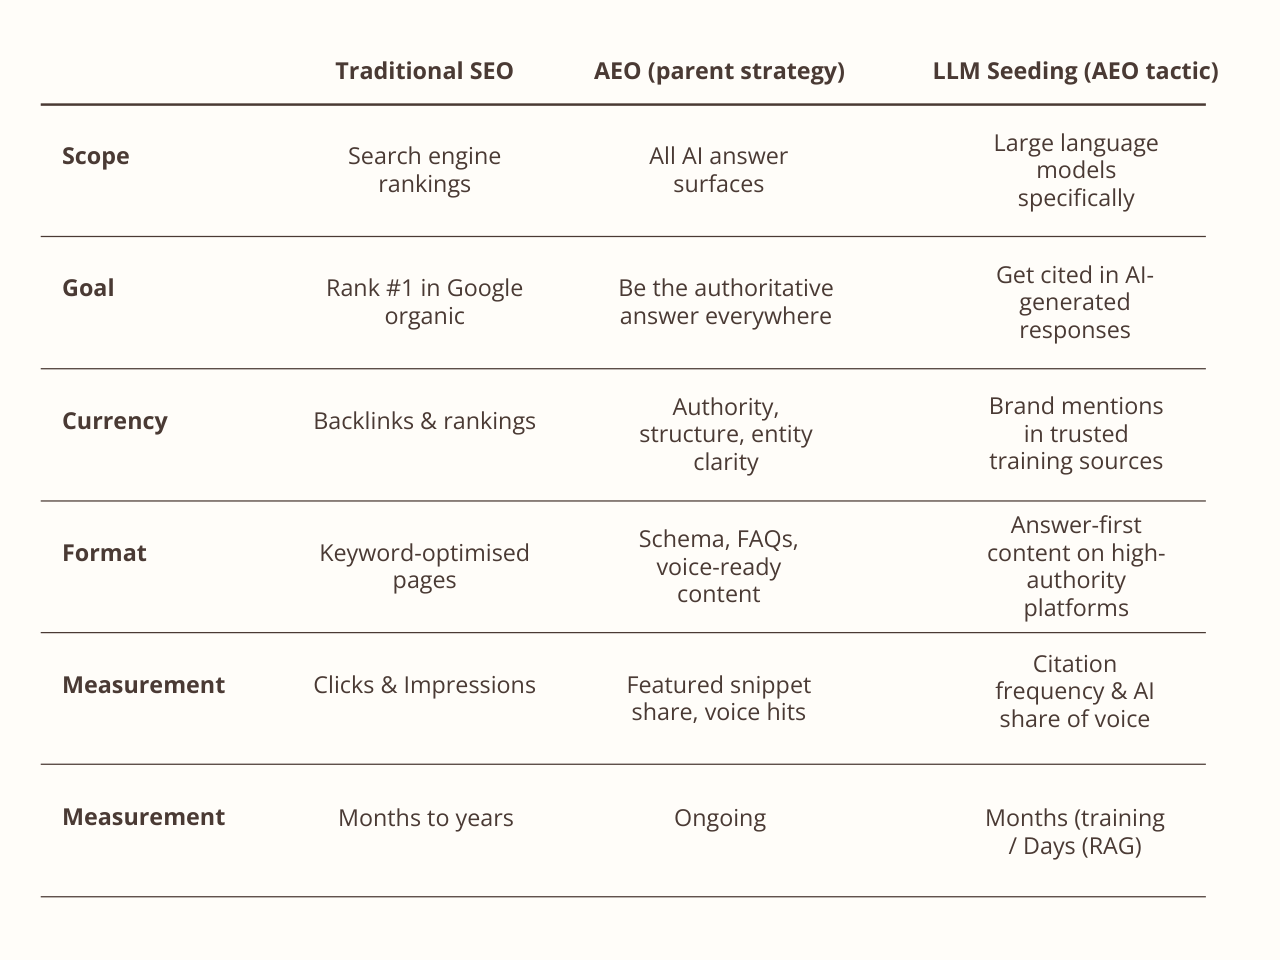
Traditionell SEO ställer frågan: Hur hamnar jag på första sidan i sökresultaten? LLM seeding ställer frågan: Hur blir jag en källa som AI litar tillräckligt mycket på för att citera? Skillnaden är avgörande – både för hur du arbetar och för vad som krävs för att lyckas. Tabellen nedan visar de viktigaste skillnaderna:
Så hittar AI-modeller ditt varumärke – och väljer att hänvisa till det
För att förstå varför AI hänvisar till vissa varumärken behöver du förstå de två grundläggande sätt som stora språkmodeller hämtar sin information på.
Parametrisk kunskap (träningsdata)
Det här är allt modellen har lärt sig under träningen från enorma mängder webbinnehåll, böcker, Wikipedia, Reddit och otaliga andra källor. Ungefär 22 % av träningsdatan för stora AI-modeller kommer enbart från Wikipedia. Kunskapen är statisk och speglar informationen som fanns när träningen avslutades. Modellen kan använda den på millisekunder, utan att hämta något från externa källor.
Varumärken och andra entiteter som ofta nämns i auktoritativa källor under träningen får starkare representationer i modellens neurala nätverk. Det gör dem betydligt mer benägna att dyka upp i svaren. Omkring 60 % av frågorna till ChatGPT besvaras enbart med den här inlärda kunskapen, utan någon sökning på webben.
Vad det betyder för dig: Om ditt varumärke, din produkt eller din expertis inte finns representerad i flera auktoritativa källor innan modellens träning avslutas, är du i praktiken osynlig i merparten av de frågor modellen besvarar utifrån sin inlärda kunskap.
Hämtad kunskap (RAG – Retrieval-Augmented Generation)
I de återstående 40 % av fallen hämtar moderna AI-system aktivt aktuell information. Användarens fråga omvandlas till vektorrepresentationer, så kallade embeddings. Relevanta dokument hämtas och rangordnas, och modellen sammanställer sedan ett svar utifrån dessa källor. Det är så tjänster som Perplexity, Googles AI Overviews och ChatGPT Search arbetar när de söker på webben i realtid.
Vad det betyder för dig: När AI hämtar information i realtid spelar aktualitet, genomsökbarhet, strukturerad data och domänens auktoritet stor roll. En välstrukturerad sida som publicerades förra månaden på en betrodd domän kan prestera bättre än en svåråtkomlig, tre år gammal artikel – även om den äldre artikeln kommer från ett större varumärke.
Tre signaler som avgör om AI hänvisar till dig
Oavsett hur modellen hämtar sin information finns det tre faktorer som återkommande skiljer varumärken som blir citerade från dem som förblir osynliga:
Samstämmighet. Informationen om ditt varumärke är korrekt och konsekvent i flera betrodda källor. Motstridiga eller knapphändiga uppgifter skapar osäkerhet hos modellen. Och när modellen är osäker minskar sannolikheten att den hänvisar till dig.
Struktur. Innehållet har tydliga rubriker, förklarade begrepp, frågor och svar, schemamärkning och listor som AI kan tolka utan tvetydighet. Studier visar att 44,2 % av alla källhänvisningar från stora språkmodeller hämtas från artikelns första 30 %. Ge läsaren svaret tidigt.
Auktoritet. Omnämnanden från tredje part, recensioner, närvaro på Wikipedia och hänvisningar från etablerade publikationer signalerar trovärdighet. Sökvolymen för varumärket är en starkare indikator på AI-citeringar än bakåtlänkar, med en korrelation på 0,334. Det är högre än korrelationen på 0,255 mellan antalet hänvisande domäner och placeringar i organiska sökresultat.
Därför behöver du agera nu – siffrorna talar sitt tydliga språk
Intresset för LLM seeding drivs av mer än hajp. Siffrorna visar varför det är dags att ta kanalen på allvar.
Trafiken är liten, men växer explosionsartat. Trafik från AI-hänvisningar står i dag för mindre än 2 % av den totala webbtrafiken. Men mellan januari och maj 2025 ökade den med 527 % jämfört med samma period året innan. Enligt Semrushs prognos kan trafik från AI-sök gå om traditionell söktrafik före slutet av 2027.
Räknar man även in AI Overviews blir trafikandelen betydligt större. Det är också sannolikt att det totala antalet sökningar har ökat markant. Många frågor ställs direkt till språkmodeller och besvaras utan att användaren klickar vidare till en webbplats.
Besökarna konverterar betydligt bättre. En studie av över 1 200 publicistsajter visade att 1,66 % av besökarna från stora språkmodeller registrerade sig, jämfört med bara 0,15 % av besökarna från traditionell sök. En annan studie visade att besökare från AI konverterar 4,4 gånger oftare än besökare från organisk sök.
Varför? När en språkmodell hänvisar till dig har användaren redan fått hjälp att jämföra alternativen. AI har bedömt ditt varumärke som trovärdigt och presenterat det som ett relevant svar. Besökaren kommer därför till din webbplats med mer kunskap och ett tydligare intresse.
Synlighet räknas även utan klick. I dag avslutas 60 % av sökningarna utan ett enda klick. Även om användaren aldrig besöker din webbplats kan ett omnämnande i ett AI-svar bygga varumärkeskännedom och leda till att personen söker direkt efter ditt varumärke senare. Korrelationen mellan omnämnanden i AI-chattbotar och varumärkessökningar är 0,334 – högre än sambandet mellan länkar och ranking som SEO har byggt på i två decennier.
Fler varumärken får chansen att konkurrera. Nästan 90 % av ChatGPT källhänvisningar går till sidor som ligger på plats 21 eller längre ned i Google. AI lyfter alltså inte automatiskt fram samma webbplatser som dominerar traditionell sök. En välstrukturerad artikel på Googles fjärde resultatsida kan få större genomslag i AI-svar än konkurrentens topprankade sida, om den ger bättre och tydligare svar.
Det finns fortfarande utrymme att ta ett försprång. I slutet av 2025 mätte bara 16 % av varumärkena systematiskt sina resultat i AI-sök. Majoriteten av dina konkurrenter optimerar utan att veta vad som fungerar – eller gör ingenting alls. Möjligheten att ta täten finns fortfarande, men den kommer inte att vara öppen för alltid.
En strategi för LLM seeding – steg för steg
Steg 1: Kartlägg kundernas AI-frågor innan du skriver ett enda ord
Innan du skapar innehåll behöver du förstå hur dina kunder ställer frågor till AI. Det skiljer sig från hur de söker på Google. AI-frågor är ofta formulerade som en konversation, med tydligt sammanhang och specifika behov: ”Vilket är det bästa GDPR-kompatibla lönesystemet för ett europeiskt startupbolag med 50 anställda?” är en typisk AI-fråga. ”Löneprogram Europa” är en typisk Google-sökning.
När besökaren väl kommer till din webbplats behöver du möta samma förväntan på dialog. En chattfunktion gör det möjligt att fortsätta samtalet och hjälpa besökaren vidare utifrån just deras situation.
Skapa en karta över de frågor en potentiell kund kan ställa till en AI-assistent under hela köpresan: när behovet uppstår, när alternativen jämförs, inför köpbeslutet och efter köpet. Utgå från användarens avsikt, inte bara från sökord. Målet är att förstå vilka samtal ditt varumärke behöver vara en naturlig del av.
Börja praktiskt: ställ relevanta branschfrågor till ChatGPT, Le Chat från Mistral, Perplexity och Claude. Studera vilka varumärken och källor som nämns, hur de presenteras och vilka mönster som återkommer.
Steg 2: Publicera trovärdigt innehåll som ger svaret direkt
Den viktigaste innehållsprincipen för LLM seeding är enkel: börja med svaret och förklara sedan. AI-modeller föredrar innehåll där huvudbudskapet kommer redan i första stycket. Underbygg därefter svaret med konkreta uppgifter: statistik, jämförelser, namngivna exempel och expertperspektiv.
En central metod är semantisk indelning, eller semantic chunking. Det innebär att dela upp innehållet i korta avsnitt med tydliga rubriker, där varje avsnitt behandlar en enda idé eller besvarar en specifik fråga. Det gör det lättare för AI att tolka innehållet, plocka ut relevanta delar och hänvisa till dem.
Använd samma grundstruktur i varje avsnitt. En konsekvent uppbyggnad gör innehållet lättare att följa och enklare för AI att använda som källa.
Se till att varje text innehåller:
- Ett direkt svar på huvudfrågan i första stycket
- Tydliga H2- och H3-rubriker som speglar hur användaren skulle formulera sin fråga
- Korta avsnitt som går att förstå fristående
- Konkreta, verifierbara fakta: datum, procentsatser, företagsnamn och källor till studier
- En kort sammanfattning med de viktigaste slutsatserna – sådana lyfts ofta in i AI-svar
- Vanliga frågor och svar formulerade på samma naturliga sätt som verkliga AI-frågor
Undvik vaga formuleringar och överdrivet försiktiga påståenden. AI läser ditt innehåll mycket bokstavligt. ”Marknadsledande lösningar som skapar affärsnytta” ger modellen inget konkret att använda. ”Verktyget minskar svarstiden i kundservice med 40 % på mindre än 30 dagar, baserat på data från 200 implementeringar” gör det.
Steg 3: Bygg ett nätverk av samstämmiga omnämnanden från andra
Din egen webbplats är en röst. AI förtroende växer när flera oberoende röster säger samma sak. Målet är därför att korrekt och konsekvent information om ditt varumärke ska finnas i många betrodda källor.
PR och mediekontakter: Ett enda omnämnande i en respekterad branschpublikation kan väga tyngre som källa än ett dussin inlägg på din egen blogg. Varumärken som tillhör den översta fjärdedelen sett till omnämnanden på webben får tio gånger större synlighet i AI än andra. Arbeta för att få in gästartiklar, expertkommentarer och produktpresentationer i branschmedier. Tjänster som HARO, senare Connectively, och Featured.com är exempel på plattformar som har hjälpt företag att hitta journalister som söker expertbidrag.
Wikipedia: Eftersom ungefär 22 % av träningsdatan för stora AI-modeller kommer från Wikipedia kan en neutral och väl underbyggd närvaro där ge stor effekt för etablerade varumärken. Följ Wikipedias redaktionella riktlinjer noggrant. Innehåll som uppfattas som reklam riskerar att tas bort och kan även skada varumärkets upplevda trovärdighet i AI-system.
Konkreta kundrecensioner: Recensioner på G2, Capterra, Trustpilot och Google Företagsprofil skapar användargenererat innehåll som AI kan hämta när någon ställer frågor inför ett köp. Här spelar detaljerna stor roll. En recension som säger ”Vi minskade antalet supportärenden med 35 % under första kvartalet” ger AI något konkret att citera. ”Fantastisk produkt, rekommenderas varmt” tillför betydligt mindre.
Hjälp dina mest nöjda kunder att bli konkreta genom att ställa tydliga frågor: ”Vilket problem löste produkten, och vilka mätbara resultat såg ni?”
Steg 4: Håll budskapet konsekvent i alla kanaler
Det här steget förbises ofta, trots att det är avgörande. AI-modeller kopplar ihop varumärken och ämnen genom att identifiera mönster i data. Om budskapet är spretigt, skiftar över tid eller skiljer sig mellan kanaler blir mönstren svagare.
Om ditt varumärke positioneras på ett sätt i bloggen, ett annat på LinkedIn och ett tredje i pressmeddelanden blir kopplingen mellan varumärket och ditt kärnområde otydlig.
Välj ut de tre till fem ämnesområden som är viktigast för ditt varumärke – de områden du vill äga i AI-svaren. Förstärk sedan samma kopplingar överallt: på webbplatsen, i gästartiklar, i diskussionsforum, i expertcitat och i sociala medier.
Ju oftare ditt varumärke förekommer i samma sammanhang med samma tydliga budskap, desto starkare och mer entydig blir representationen av varumärket i träningsdatan.
Steg 5: Etablera och stärk ditt varumärke i kunskapsgrafer
AI-modeller arbetar med entiteter: tydligt avgränsade och igenkännbara företeelser, som företag, personer och produkter. Starka varumärken har tydliga entitetsrepresentationer. Namn, egenskaper och kopplingar till andra ämnen är konsekventa i många olika källor. Svaga representationer bygger på knapphändig, tvetydig eller motstridig information.
Så stärker du ditt varumärke som entitet:
- Se till att din Google Företagsprofil är komplett, korrekt och uppdateras regelbundet
- Använd samma företagsnamn, adress och telefonnummer på alla plattformar, ofta kallat NAP: Name, Address, Phone
- Använd strukturerad data för att tydligt beskriva varumärket och dess egenskaper
- Koppla ditt innehåll till etablerade entiteter, som branschbegrepp, välkända verktyg och namngivna ramverk, så att AI lättare kan placera varumärket i sitt befintliga kunskapssammanhang
Steg 6: Publicera egna data och originalstudier
En av de mest effektiva metoderna inom LLM seeding är att bli ursprungskällan till unik information. När en språkmodell hittar en uppgift som bara du kan belägga får den en anledning att återkomma till din källa. Genomför mindre enkätundersökningar, analysera egna kunddata eller beställ en studie från en oberoende aktör. Presentera resultaten med tydlig information om datum, metod och antal deltagare eller observationer.
Det gör uppgifterna möjliga att kontrollera och använda som källa – två viktiga förutsättningar för att AI ska kunna ta med dem i ett svar.
De bästa plattformarna för LLM seeding
Alla innehållskanaler når AI-modeller lika effektivt. Prioritera utifrån de två vägarna till synlighet: träningsdata och informationshämtning i realtid.
Publiceringsplattformar med hög auktoritet (LinkedIn, Medium, Substack): De genomsöks ofta, har hög domänauktoritet och får nytt innehåll indexerat snabbt. Artiklar på LinkedIn är kopplade till verkliga yrkesprofiler, vilket ger en trovärdighetssignal som språkmodeller reagerar på. Mediums avskalade och tydliga innehållsstruktur är lätt för AI att tolka. Substack passar för expertinnehåll och nyhetsbrev, där en tydlig redaktionell röst och fördjupning inom ett ämne stärker auktoriteten.
Branschpublikationer och redaktionella omnämnanden: Nischade webbplatser med hög auktoritet väger tungt när AI söker expertkällor inom en viss bransch. För specifika frågor kan ett omnämnande i en respekterad branschblogg ge större effekt än bred bevakning i allmänna medier. Att komma med i rekommendationslistor i nyhetsbrev, blogginlägg och kurerade sammanställningar är särskilt värdefullt. Sådana format hör till dem som språkmodeller oftast hänvisar till.
Recensions- och jämförelseplattformar (G2, Capterra, Trustpilot): Dessa citeras ofta när användare ber AI att rekommendera verktyg. Plattformarna har ett grundläggande förtroende eftersom de samlar oberoende användarupplevelser. Prioritera utförliga, konkreta recensioner från verkliga kunder.
Reddit och Quora: Enligt Semrush hänvisar språkmodeller oftare till Reddit än till någon annan enskild källa. Quora är den webbplats som citeras mest i Googles AI Overviews. På båda plattformarna fungerar konkreta, kunniga och tydligt strukturerade svar bäst. Bidra med hjälp som faktiskt löser användarens problem och låt expertisen bygga förtroendet.
YouTube: Hänvisningar till YouTube i AI-svar ökade tydligt under 2025, i takt med att AI-systemen blev bättre på att använda transkriptioner, undertexter och videobeskrivningar. Optimera titlar, beskrivningar och undertexter enligt samma principer som ditt skrivna innehåll.
GitHub Discussions: För tekniska varumärken är diskussioner på GitHub en stark men ofta outnyttjad kanal för LLM seeding. Genom att delta i relevanta trådar, besvara frågor och bidra med lösningar bygger du trovärdighet som AI kan fånga upp när utvecklare söker hjälp.
Redaktionella mikrosajter: En separat mikrosajt med redaktionell struktur och fokus på din bransch kan bli en mer trovärdig källa än en vanlig företagssida. IKEA forskningssajt Life at Home är ett bra exempel. Den publicerar egna data om livet hemma och välbefinnande, med en tydlig koppling till varumärket. Ge sajten en genomarbetad redaktionell struktur, presentera skribenterna, ange källor och gör de redaktionella riktlinjerna synliga.
Din egen webbplats (med teknisk AEO): Här ligger grunden. Även när AI inte hänvisar direkt till din domän stärker en välstrukturerad och trovärdig webbplats modellens bild av ditt varumärke. Den kan också fungera som en återkommande källa när AI hämtar information via RAG.
Innehållsformat som får AI att hänvisa till dig
Formatet spelar lika stor roll som innehållet. Vissa strukturer gör det helt enkelt lättare för AI att plocka ut information, formulera om den och ange dig som källa.
Topplistor med transparent metodik hör till de format som fungerar bäst för att få källhänvisningar från språkmodeller. Men en enkel rangordning räcker inte. Förklara hur du valde alternativen: hur du testade dem, vilka kriterier du använde och hur bedömningen gick till. Språkmodeller prioriterar innehåll där urvalet är tydligt och väl motiverat.
Ge varje alternativ en specifik etikett som speglar verkliga frågor, till exempel ”bäst för frilansare med liten budget” eller ”bäst för stora organisationer”. AI kan använda sådana formuleringar direkt när den anpassar svaret till användarens situation. Följ samma struktur för varje alternativ: namn, sammanfattning, viktigaste funktioner, fördelar och nackdelar samt pris.
Produktrecensioner baserade på egna tester och mätbara resultat ger AI tre starka skäl att hänvisa till innehållet: praktisk erfarenhet, en metod som går att upprepa och konkreta slutsatser. Ange hur många produkter du testade, vem som genomförde testerna, när de gjordes och vilka kriterier som användes.
Skriv korta, tydliga meningar som väger styrkor mot svagheter. ”Det är det bästa valet för team med färre än 20 personer, men saknar de avancerade rapportfunktioner som större organisationer behöver” är betydligt lättare för AI att använda än ett långt stycke där slutsatsen är inbäddad.
Innehåll med frågor och svar speglar hur användare ställer frågor till AI. Formatet gör det enkelt för modellen att hitta både frågan och det relevanta svaret. Varje viktig sida på webbplatsen bör ha ett avsnitt med vanliga frågor som utgår från vad användarna faktiskt frågar AI-tjänsterna om. WordPress-tillägg som Rank Math och Yoast kan lägga till strukturerad data av typen FAQPage, vilket hjälper maskiner att identifiera frågor och svar.
Jämförelsetabeller används ofta i svar som ska hjälpa användaren att fatta ett beslut. Gå längre än att bara jämföra funktioner. Visa vilket alternativ som passar bäst för olika behov, vilka avvägningar användaren behöver göra och varför. Formulera slutsatserna så tydligt att AI kan använda dem direkt.
Numrerade listor och steg-för-steg-guider gör det lätt för modeller att följa och återge en process. En guide med tydligt numrerade steg är enklare att hänvisa till än löpande text som behandlar samma ämne.
Texter med en tydlig ståndpunkt och konkreta slutsatser kan bli värdefulla källor när argumenten är väl underbyggda. Ett perspektiv som utmanar branschens etablerade uppfattningar eller en prognos baserad på data ger AI något särskiljande att hänvisa till. Det gäller särskilt när avsändaren är en namngiven expert med relevanta meriter. Använd tydliga avsnitt och sammanfatta de viktigaste slutsatserna så att huvudargumentet är lätt att hitta.
Namngivna experter och E-E-A-T-signaler stärker trovärdigheten. Presentera författaren med en kort biografi, använd direkta citat från namngivna yrkespersoner och hänvisa till specifika studier. E-E-A-T står för erfarenhet, expertis, auktoritet och trovärdighet. Innehåll som tydligt visar vem som står bakom det och vilken kompetens personen har får oftare genomslag i AI-svar.
Kundcase med konkreta resultat blir mer användbara som källor ju mer specifika de är. Mätbara resultat som ”minskade svarstiden från fyra timmar till 22 minuter” ger AI tydliga uppgifter som går att kontrollera och återge.
Verktyg, mallar och ramverk får hänvisningar eftersom de löser konkreta problem som användare återkommande söker hjälp med. När någon frågar Perplexity ”Hur kan jag kontrollera mina sökordsplaceringar gratis?” rekommenderar tjänsten specifika verktyg vid namn. Ge resursen en beskrivande titel som matchar användarnas frågor. Inled med att förklara vem den är till för och hur den används. Lägg till vanliga frågor eller konkreta användningsexempel så att AI kan förstå både sammanhanget och nyttan.
Så mäter du ditt varumärkes synlighet i AI
För att mäta resultaten av LLM seeding behöver du komplettera traditionell SEO-analys med andra metoder. Kanalen är fortfarande ung och mätvärdena mindre standardiserade, men möjligheterna att följa utvecklingen förbättras snabbt.
Signalen i Google Search Console: fler visningar, färre klick
Ett tidigt tecken på att AI påverkar kundresan kan vara ett särskilt mönster i Google Search Console: visningarna ökar samtidigt som klicken minskar.
En möjlig förklaring är att användaren ser ditt varumärke i ett AI-svar, lägger det på minnet och söker direkt efter dig dagar eller veckor senare. Det kan ge lägre klickfrekvens i organiska sökresultat samtidigt som varumärkessökningar och direkttrafik ligger stabilt eller ökar.
Så undersöker du mönstret: öppna Google Search Console och jämför visningar och klick under de senaste tre till sex månaderna. Jämför sedan med utvecklingen i Google Analytics. Om direkttrafiken ökar medan de organiska klicken minskar kan det tyda på att AI bidrar till varumärkeskännedomen. Se det som en signal att undersöka närmare.
Testa AI-frågorna manuellt. Helt gratis
Den mest direkta metoden är att regelbundet ställa samma frågor till AI som dina kunder gör och se om ditt varumärke dyker upp. Använd ett privat fönster eller inkognitoläge för att minska risken att personalisering påverkar resultaten.
Testa i ChatGPT, Perplexity, Claude och Googles AI Overviews. Samma varumärke kan förekomma i mindre än 1 % av svaren på en plattform och i över 27 % på en annan. Därför behöver du följa flera plattformar.
Bygg en frågebank med 20–30 representativa frågor från olika delar av köpresan. Kör dem varje månad och dokumentera:
- Vilken AI-tjänst du använde
- Den exakta frågan
- Om ditt varumärke förekom i svaret
- Var i svaret det nämndes
- Tonen och sammanhanget kring omnämnandet
- Vilka konkurrenter som nämndes tillsammans med dig
Det ger dig ett utgångsläge att jämföra med när du följer utvecklingen över tid.
Verktyg för att bevaka AI-synlighet
Otterly.ai: Följer källhänvisningar och varumärkesomnämnanden i AI-genererade svar från ChatGPT, Perplexity och andra tjänster.
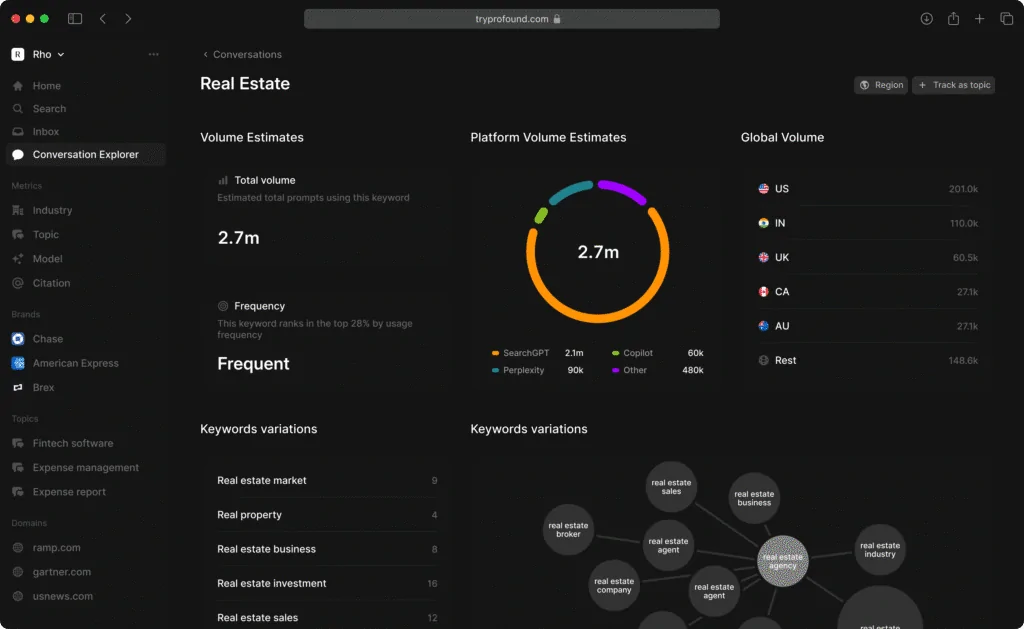
Profound AI: En plattform för större organisationer som följer sökvolym i AI-tjänster, hur ofta varumärken och källor citeras samt trafik från AI-botar.
Semrush AI Visibility Toolkit: Ett tillägg till befintliga abonnemang som följer varumärkets synlighet, share of voice och hur det framställs i ChatGPT, Perplexity och Google AI Mode. Innehåller även jämförelser med konkurrenter.
PromptMonitor: Bevakar varumärkesomnämnanden på de största plattformarna för stora språkmodeller.
Ställ in din webbanalys för AI-trafik
Se till att din webbanalys fångar upp trafik från AI-tjänster korrekt. Många analysplattformar registrerar i dag en del av den trafiken som direkttrafik. Det innebär att dina data sannolikt underskattar antalet besök från AI.
Skapa anpassade kanalgrupper som fångar upp hänvisningstrafik från ChatGPT, Perplexity, Copilot och Gemini. Följ trafiken separat och jämför konverteringsgraden med organisk sök och direkttrafik.
Fem mätvärden att fokusera på
Komplettera traditionella rankingmått med dessa nyckeltal för GEO:
- Citeringsfrekvens: Hur ofta ditt varumärke förekommer i AI-svar på de frågor du vill synas för.
- Varumärkessynlighet: Andelen av dina utvalda frågor där varumärket får ett omnämnande.
- Share of voice i AI: Din andel av samtliga citeringar och omnämnanden i kategorin.
- Sentiment: Hur AI framställer ditt varumärke – positivt, neutralt eller negativt.
- Konvertering från AI-trafik: Hur stor andel av besöken från AI som leder till köp eller leads, och vilka intäkter de genererar.
Vanliga fallgropar och rimliga förväntningar
Resultaten kan ta längre tid än inom SEO. Innehåll som ska påverka modellens träningsbaserade kunskap kan behöva flera månader för att få genomslag. Tjänster som hämtar information i realtid, som Perplexity, kan ge snabbare resultat. Räkna med en tidshorisont på tre till sex månader innan du förväntar dig stabila förändringar i citeringar från träningsbaserade modeller. LLM seeding liknar varumärkesbyggande och arbetet med att etablera en expertposition: effekten byggs upp gradvis och kan sedan accelerera.
Du kan påverka sannolikheten. AI-svar bygger på sannolikheter och kan variera även när frågan är identisk. Sannolikheten att ChatGPT ger exakt samma lista med varumärken i två svar på samma fråga är mindre än en på hundra. Du kan öka chansen att bli citerad avsevärt, men du kan aldrig garantera ett omnämnande. Det finns ingen enskild inställning som säkrar resultatet.
Insynen i träningsdatan är begränsad. Det är inte alltid tydligt vilka källor en viss modell värderar högst. LLM seeding behöver därför bygga på välgrundade strategiska antaganden: att trovärdighet, samstämmig information, ämnesdjup och omnämnanden i auktoritativa tredjepartskällor ökar sannolikheten att bli citerad. Processen är för sluten för att kunna kartläggas exakt.
Det är svårt att koppla hela effekten till rätt källa. Ett omnämnande i ett AI-svar kan bygga varumärkeskännedom utan att skapa ett mätbart webbplatsbesök. Värdet finns där, men syns inte alltid tydligt i analysverktygen. Indirekta mått som fler varumärkessökningar, växande direkttrafik och kvaliteten på säljkvalificerade leads från AI-trafik kan hjälpa dig att få en mer komplett bild.
Manipulation riskerar att slå tillbaka. Fabricerade recensioner, påhittad statistik och vilseledande innehåll kan skada synligheten när modellerna blir bättre på att upptäcka manipulation. Den hållbara strategin är att sprida korrekt, hjälpsam och välstrukturerad information genom trovärdiga källor. Det bygger både synlighet och förtroende.
Så omvandlar du AI-synlighet till intäkter
Ett omnämnande i AI skapar affärsvärde först när du tar vara på intresset. Besökare från AI konverterar ofta bättre eftersom de redan har fått hjälp att förstå alternativen och bedöma din lösning. När de kommer till webbplatsen behöver du fånga upp det intresset och hjälpa dem vidare. Här kan en chattlösning som Weply, med expertis inom leadkonvertering, spela en avgörande roll.
I en analys av 13 månaders data hade trafik från stora språkmodeller en konverteringsgrad på ungefär 18 %. Det var högre än för någon annan trafikkälla i analysen, inklusive betald sök, organisk sök och direkttrafik. Samtidigt växer AI-trafiken från en låg nivå. Även en relativt liten ökning av antalet citeringar kan därför få stor effekt på affärsresultatet.
I praktiken betyder det att besökare från AI ofta är nära ett köpbeslut eller seriöst överväger din lösning. Anpassa landningssidan efter sammanhanget de kommer från. Om AI har rekommenderat dig för ett särskilt användningsområde ska sidan direkt visa hur du möter det behovet.
Använd relevanta uppmaningar till nästa steg och erbjud chatt som hjälper besökaren att få svar på sina återstående frågor. Utgå från vad personen redan vet och gör det enkelt att gå vidare.
AI skapar synlighet och skickar besökare med tydligt intresse till din webbplats. Chatt i realtid hjälper dig att fånga upp det intresset medan det är som starkast.
Vanliga frågor om LLM seeding
Hur lång tid tar det innan LLM seeding ger resultat?
För att påverka den träningsbaserade kunskapen i modeller som ChatGPT och Claude bör du räkna med tre till sex månader innan innehållet får ett återkommande genomslag i citeringarna. Tjänster som hämtar information i realtid, som Perplexity, kan fånga upp nytt innehåll inom några dagar. Börja med att följa resultaten i Perplexity för snabbare återkoppling, samtidigt som du bygger grunden för långsiktig synlighet i träningsbaserade svar.
Är LLM seeding samma sak som SEO eller AEO?
Nej, men de hänger ihop. LLM seeding är en specifik metod inom AEO, Answer Engine Optimization, som i sin tur omfattar mer än traditionell SEO. SEO fokuserar på placeringar och klick i sökmotorer. AEO fokuserar på att bli en trovärdig källa i olika typer av svar: röstsökningar, utvalda utdrag, kunskapspaneler och AI-tjänster.
LLM seeding är en av de mest framåtblickande delarna av AEO. Arbetet handlar om att påverka vad stora språkmodeller känner till och återger om ditt varumärke genom att placera relevant innehåll i de källor AI lär sig av. Nästan 90 % av ChatGPT källhänvisningar går till sidor som ligger på plats 21 eller längre ned i Google. Det visar varför LLM seeding behöver en egen strategi som kompletterar traditionell SEO.
Fungerar LLM seeding likadant i ChatGPT, Claude och Perplexity?
Nej, och skillnaden är viktig. ChatGPT och Claude förlitar sig i större utsträckning på kunskap från träningen, vilket är svårare att påverka i realtid. Perplexity bygger främst på RAG och hämtar aktuellt innehåll när en fråga ställs. Därför kan nytt, välstrukturerat innehåll få genomslag snabbare där. Googles AI Overviews kombinerar båda vägarna.
En bred strategi med konsekvent närvaro på webben och strukturerat innehåll som är lätt att genomsöka ökar chansen att bli citerad på flera plattformar.
Kan små företag konkurrera med stora varumärken om AI-citeringar?
Ja, särskilt inom tydliga nischer. Konsekvens väger tyngre än budget. Ett mindre företag som publicerar konkreta, välstrukturerade svar på frågor där bra information saknas, får genuina kundrecensioner och bidrar med expertis i relevanta forum kan få större genomslag än en stor konkurrent med generiskt innehåll.
Identifiera de specifika, detaljerade frågor dina kunder ställer till AI och bli den bästa källan för just dem.
Hur rättar jag felaktig information som AI sprider om mitt varumärke?
Publicera korrekt och väl underbyggd information på auktoritativa plattformar. Ju fler trovärdiga källor som konsekvent återger rätt uppgifter, desto bättre förutsättningar får AI-systemen att använda dem. När en rättelse är särskilt viktig bör du prioritera Wikipedia, om det är relevant för ditt varumärke, större recensionsplattformar och redaktionell mediebevakning. Dessa källor väger tungt både i träningsdata och när AI hämtar aktuell information.
Är LLM seeding etiskt?
Ja, när arbetet handlar om att göra sann och hjälpsam information om ditt varumärke tillgänglig. Målet är att AI ska kunna hitta och verifiera korrekta uppgifter. Användbart innehåll, autentiska recensioner och verklig trovärdighet hos oberoende källor är grunden för en strategi som både fungerar och håller över tid.