Besøkende fra AI konverterer i opptil 18 % av tilfellene. Det er omtrent 4–10 ganger høyere enn for besøkende fra organiske søk. Likevel står trafikk fra AI-henvisninger fortsatt for mindre enn 2 % av den totale nettrafikken. Merkevarer som mestrer LLM seeding nå, bygger et forsprang som vokser over tid, før konkurransen tiltar. Denne guiden viser deg hvordan.
Konkurrenten din dukket nettopp opp i et svar fra ChatGPT. Merkevaren din gjorde det ikke. Det er ingen tilfeldighet. Bak synligheten ligger en bevisst strategi som kalles LLM seeding: å systematisk bygge merkevarens tilstedeværelse på nettet slik at store språkmodeller henviser til deg når brukerne stiller spørsmål som er viktige for virksomheten din. LLM seeding er en del av den overordnede strategien din for Answer Engine Optimization (AEO).
Spillereglene endrer seg raskt. Store språkmodeller henviser bare til 2–7 domener per svar, sammenlignet med Googles ti blå lenker og flere resultater videre nedover. Konkurransen om disse få plassene blir stadig hardere. Når en modell først har etablert en kilde som troverdig, har den en tendens til å bruke den igjen i svar på beslektede spørsmål.
Det skaper en dynamikk der de som tar ledelsen, får en uforholdsmessig stor del av synligheten. Hvis merkevaren din mangler i svarene i dag, lærer brukerne å forbinde kategorien din med en konkurrent.
Denne guiden går gjennom hvordan AI-modeller velger hvilke kilder de henviser til, hvilke strategier som gir gjentatte omtaler, hvilke plattformer som veier tyngst, og hvordan du måler om arbeidet gir resultater.
Hva er LLM seeding?
LLM seeding handler om å spre korrekt, troverdig og maskinlesbart innhold strategisk på nettet, slik at AI-tjenester som ChatGPT, Claude, Perplexity og Googles AI Overviews tar med merkevaren din i svarene sine. Det er en del av det bredere arbeidet med Answer Engine Optimization (AEO).
Begrepet består av to deler:
- LLM (Large Language Model): En stor språkmodell – AI-teknologien bak tjenester som ChatGPT, Claude, Perplexity og Gemini.
- Seeding: Å så frø ved å plassere informasjon om merkevaren der AI henter grunnlaget for svarene sine: i treningsdata, troverdige nettkilder og på autoritative plattformer.
Tradisjonell SEO spør: Hvordan kommer jeg på førstesiden i søkeresultatene? LLM seeding spør: Hvordan blir jeg en kilde AI stoler nok på til å sitere?
Forskjellen er avgjørende for både hvordan du jobber, og hva som kreves for å lykkes. Tabellen nedenfor viser de viktigste forskjellene:
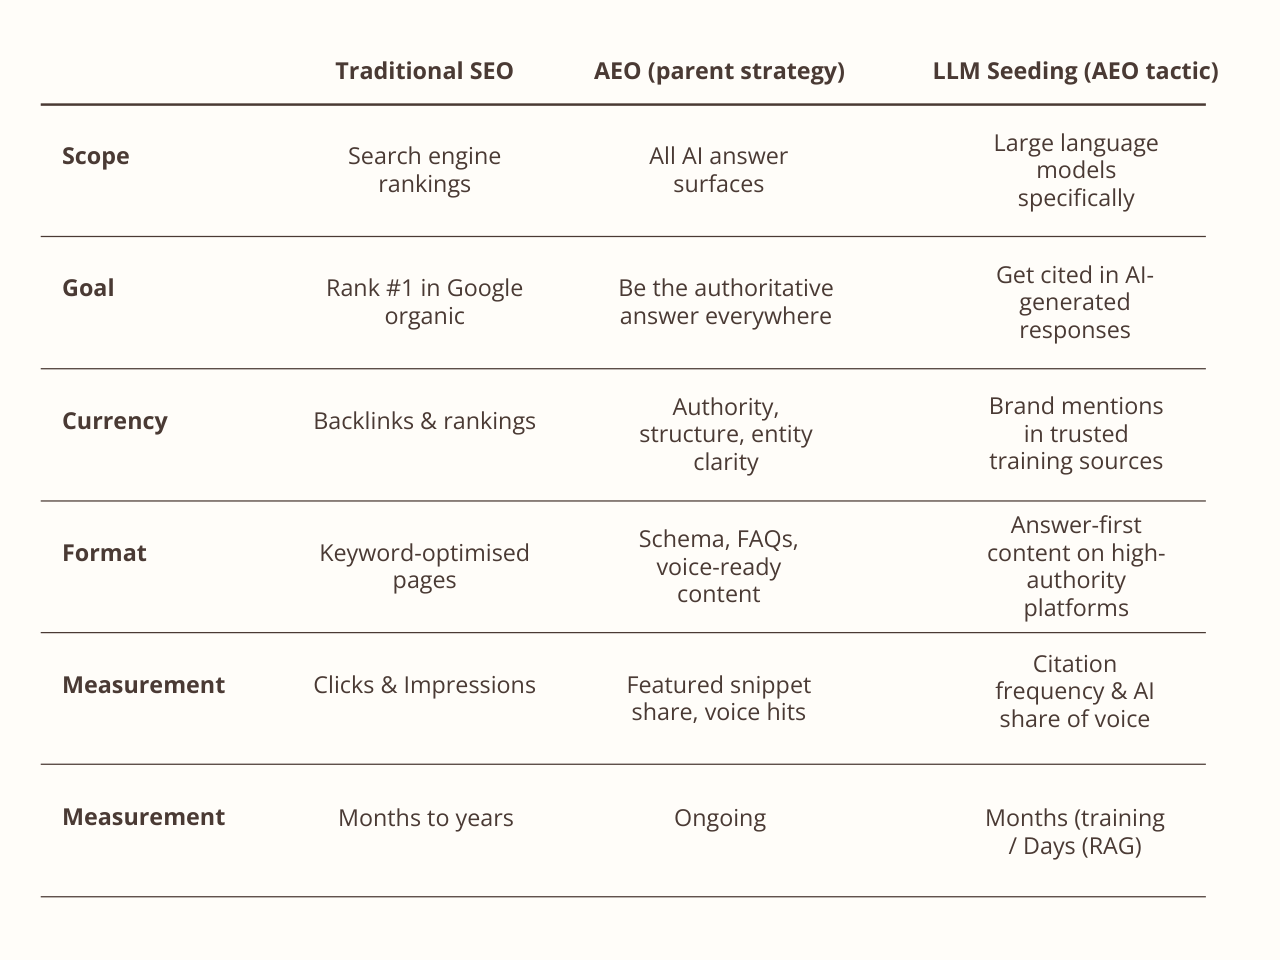
Slik finner AI-modeller merkevaren din – og velger å sitere den
For å forstå hvorfor AI henviser til bestemte merkevarer, må du forstå de to grunnleggende måtene store språkmodeller bruker informasjon på.
Parametrisk kunnskap (treningsdata)
Dette er alt modellen har lært under treningen, fra enorme mengder nettinnhold, bøker, Wikipedia, Reddit og utallige andre kilder. Omtrent 22 % av treningsdataene for store AI-modeller kommer fra Wikipedia alene. Denne kunnskapen er statisk og gjenspeiler informasjonen som var tilgjengelig da treningen ble avsluttet. Modellen kan bruke den på millisekunder, uten å hente informasjon fra eksterne kilder.
Merkevarer og andre entiteter som ofte omtales i autoritative kilder under treningen, får sterkere representasjoner i modellens nevrale nettverk. Det øker sannsynligheten for at de dukker opp i svarene. Rundt 60 % av spørsmålene til ChatGPT besvares bare med denne innlærte kunnskapen, uten noe søk på nettet.
Hva det betyr for deg: Hvis merkevaren, produktet eller ekspertisen din ikke finnes i flere autoritative kilder før modellens trening avsluttes, er du i praksis usynlig i mange av svarene som bygger på modellens innlærte kunnskap.
Innhentet kunnskap (RAG – Retrieval-Augmented Generation)
I de resterende 40 % av tilfellene henter moderne AI-systemer aktivt oppdatert informasjon. Brukerens spørsmål omgjøres til vektorrepresentasjoner, såkalte embeddings. Relevante dokumenter hentes inn og rangeres, før modellen setter sammen et svar basert på kildene. Det er slik tjenester som Perplexity, Googles AI Overviews og ChatGPT Search fungerer når de søker på nettet i sanntid.
Hva det betyr for deg: Aktualitet, muligheten for å bli gjennomsøkt, strukturerte data og domeneautoritet har stor betydning. En godt strukturert side publisert forrige måned på et troverdig domene kan få større gjennomslag enn en bortgjemt, tre år gammel artikkel – selv om den eldre artikkelen kommer fra en større merkevare.
Tre signaler som avgjør om AI henviser til deg
Uansett hvordan modellen henter informasjon, er det tre faktorer som går igjen hos merkevarene som blir sitert:
Konsistens. Informasjonen om merkevaren din er korrekt og samsvarer på tvers av flere troverdige kilder. Motstridende eller mangelfulle opplysninger skaper usikkerhet. Når modellen er usikker, blir det mindre sannsynlig at den henviser til deg.
Struktur. Innholdet har tydelige overskrifter, forklarte begreper, spørsmål og svar, schemamarkering og lister som AI kan tolke entydig. Studier viser at 44,2 % av alle kildehenvisninger fra store språkmodeller hentes fra de første 30 % av en artikkel. Gi svaret tidlig.
Autoritet. Omtaler fra tredjeparter, anmeldelser, tilstedeværelse på Wikipedia og henvisninger fra etablerte publikasjoner signaliserer troverdighet. Søkevolumet for merkevaren er en sterkere indikator på AI-siteringer enn tilbakekoblinger, med en korrelasjon på 0,334. Det er høyere enn korrelasjonen på 0,255 mellom henvisende domener og organiske plasseringer.
Derfor bør du prioritere LLM seeding nå
Interessen for LLM seeding bygger på mer enn hype. Tallene viser hvorfor det er verdt å ta kanalen på alvor.
Trafikken er liten, men vokser kraftig. Trafikk fra AI-henvisninger står i dag for mindre enn 2 % av den totale nettrafikken. Men mellom januar og mai 2025 økte den med 527 % sammenlignet med samme periode året før. Ifølge Semrushs prognose kan trafikk fra AI-søk passere tradisjonell søketrafikk innen utgangen av 2027. Regner man også med AI Overviews, blir trafikkandelen betydelig høyere. Det er dessuten sannsynlig at det totale antallet søk har økt. Mange spørsmål stilles direkte til språkmodeller og besvares uten at brukeren klikker videre til et nettsted.
De besøkende konverterer langt bedre. En studie av over 1 200 publisistnettsteder fant at 1,66 % av besøkende fra store språkmodeller registrerte seg, sammenlignet med bare 0,15 % fra tradisjonelle søk. En annen studie fant at besøkende fra AI konverterer 4,4 ganger oftere enn besøkende fra organiske søk. Hvorfor? Når en språkmodell henviser til deg, har brukeren allerede fått hjelp til å vurdere alternativene. AI har sammenlignet deg med konkurrentene, vurdert deg som troverdig og presentert deg som et relevant svar. Den besøkende kommer derfor med mer kunnskap og et tydeligere behov.
Synlighet har verdi også uten klikk. 60 % av søkene avsluttes nå uten et eneste klikk. Selv når brukeren aldri besøker nettstedet ditt, kan en omtale i et AI-svar bygge kjennskap og føre til at personen søker direkte etter merkevaren senere. Korrelasjonen mellom omtaler i AI-chatboter og merkevaresøk er 0,334 – høyere enn sammenhengen mellom lenker og plasseringer som SEO har støttet seg på i to tiår.
Flere merkevarer får muligheten til å konkurrere. Nesten 90 % av ChatGPTs kildehenvisninger går til sider som ligger på plass 21 eller lenger ned i Google. AI velger altså ikke automatisk de samme nettstedene som dominerer tradisjonelle søk. En godt strukturert artikkel på Googles fjerde resultatside kan få større gjennomslag i AI-svar enn konkurrentens topprangerte side, hvis den gir bedre og tydeligere svar.
Det er fortsatt mulig å ta et forsprang. Ved utgangen av 2025 målte bare 16 % av merkevarene resultatene fra AI-søk systematisk. De fleste konkurrentene dine optimaliserer uten å vite hva som virker, eller gjør ingenting. Muligheten til å ta ledelsen er der fortsatt, men konkurransen vil tilta.
En strategi for LLM seeding – steg for steg
Steg 1: Kartlegg kundenes AI-spørsmål før du skriver et eneste ord
Før du lager innhold, må du forstå hvordan kundene dine stiller spørsmål til AI. Det skiller seg fra hvordan de søker på Google. AI-spørsmål er ofte formulert som en samtale, med tydelig kontekst og konkrete behov: «Hva er det beste GDPR-kompatible lønnssystemet for en europeisk oppstartsbedrift med 50 ansatte?» er et typisk AI-spørsmål. «Lønnsprogram Europa» er et typisk Google-søk. Når den besøkende kommer til nettstedet ditt, bør du møte den samme forventningen om dialog. En chat gjør det mulig å fortsette samtalen og hjelpe kunden videre ut fra deres situasjon.
Lag et kart over spørsmålene en potensiell kunde kan stille til en AI-assistent gjennom hele kjøpsreisen: når behovet oppstår, når alternativer vurderes, før kjøpsbeslutningen og etter kjøpet. Tenk på brukerens intensjon, ikke bare søkeord. Målet er å forstå hvilke samtaler merkevaren din bør være en naturlig del av.
Begynn praktisk: Still relevante bransjespørsmål til ChatGPT, Le Chat fra Mistral, Perplexity og Claude. Se hvilke kilder og merkevarer som blir sitert, hvordan de omtales, og hvilke mønstre som går igjen.
Steg 2: Publiser troverdig innhold som gir svaret først
Det viktigste innholdsprinsippet for LLM seeding er enkelt: Begynn med svaret, og forklar deretter. AI-modeller foretrekker innhold der hovedbudskapet kommer i første avsnitt. Underbygg så svaret med konkrete opplysninger: statistikk, sammenligninger, navngitte eksempler og faglige vurderinger. En sentral metode er semantisk oppdeling, eller semantic chunking. Det betyr å dele innholdet i korte avsnitt med tydelige overskrifter, der hvert avsnitt handler om én idé eller besvarer ett spørsmål. Det gjør det lettere for AI å tolke innholdet, hente ut relevante deler og sitere dem.
Bruk en konsekvent oppbygning. En gjenkjennelig struktur gjør innholdet enklere å følge og bruke som kilde.
Sørg for at hver tekst har:
- Et direkte svar på hovedspørsmålet i første avsnitt
- Tydelige H2- og H3-overskrifter som speiler hvordan brukeren ville formulert spørsmålet
- Korte avsnitt som kan forstås uavhengig av resten av teksten
- Konkrete, etterprøvbare fakta: datoer, prosenter, selskapsnavn og kilder til studier
- En kort oppsummering av de viktigste poengene – slike sammendrag hentes ofte inn i AI-svar
- Vanlige spørsmål og svar formulert slik kundene faktisk spør AI
Unngå vage formuleringer og unødvendige forbehold. AI leser innholdet ditt svært bokstavelig. «Markedsledende løsninger som skaper bedre forretningsresultater» gir lite konkret å bruke. «Verktøyet reduserer svartiden i kundeservice med 40 % på under 30 dager, basert på data fra 200 implementeringer» gir en tydelig opplysning å hente ut.
Steg 3: Bygg et nettverk av troverdige omtaler fra tredjeparter
Nettstedet ditt er én stemme. AI får større tillit når flere uavhengige kilder bekrefter den samme informasjonen. Målet er derfor at korrekte opplysninger om merkevaren din skal finnes på tvers av mange troverdige kilder.
PR og mediekontakt: Én omtale i en respektert bransjepublikasjon kan veie tyngre som kilde enn et dusin innlegg på din egen blogg. Merkevarer i den øverste fjerdedelen målt i omtaler på nettet får ti ganger større AI-synlighet enn andre. Jobb for å få publisert fagartikler, ekspertkommentarer og produktomtaler i bransjemedier. Tjenester som HARO, senere Connectively, og Featured.com er eksempler på plattformer som har koblet journalister med relevante fagpersoner.
Wikipedia: Siden omtrent 22 % av treningsdataene for store AI-modeller kommer fra Wikipedia, kan en nøytral og godt dokumentert tilstedeværelse der gi stor effekt for etablerte merkevarer. Følg Wikipedias redaksjonelle retningslinjer nøye. Innhold som oppfattes som reklame, risikerer å bli slettet og kan svekke merkevarens opplevde troverdighet i AI-systemer.
Konkrete kundeanmeldelser: Anmeldelser på G2, Capterra, Trustpilot og Google-bedriftsprofilen skaper brukergenerert innhold som AI kan hente når noen vurderer et kjøp. Detaljene er avgjørende. «Vi reduserte antallet supporthenvendelser med 35 % i første kvartal» gir AI noe konkret å sitere. «Fantastisk produkt, anbefales på det sterkeste» tilfører langt mindre. Hjelp de mest fornøyde kundene dine med å være konkrete: «Hvilket problem løste dette, og hvilke målbare resultater fikk dere?»
Steg 4: Hold budskapet konsekvent i alle kanaler
Dette steget blir ofte oversett, selv om det er avgjørende. AI-modeller kobler merkevarer til temaer ved å finne mønstre i data. Hvis budskapet spriker, endrer seg stadig eller varierer mellom kanaler, blir mønstrene svakere. Hvis merkevaren posisjoneres på én måte i bloggen, en annen på LinkedIn og en tredje i pressemeldinger, blir koblingen til kjerneområdet ditt uklar. Velg de tre til fem viktigste temaene du ønsker at merkevaren skal forbindes med – områdene du vil eie i AI-svarene. Forsterk disse koblingene konsekvent på nettstedet, i gjesteartikler, foruminnlegg, ekspertuttalelser og sosiale medier. Jo oftere merkevaren din opptrer i de samme sammenhengene med et tydelig budskap, desto sterkere og mer entydig blir representasjonen av den i treningsdataene.
Steg 5: Styrk merkevaren din i kunnskapsgrafer
AI-modeller bruker entiteter: tydelig avgrensede og gjenkjennelige størrelser, som selskaper, personer og produkter. Sterke merkevarer har tydelige entitetsrepresentasjoner. Navn, egenskaper og koblinger til temaer samsvarer på tvers av mange kilder. Svake representasjoner bygger på mangelfull, tvetydig eller motstridende informasjon.
Slik styrker du merkevaren som entitet:
- Sørg for at Google-bedriftsprofilen er komplett, korrekt og oppdateres jevnlig
- Bruk samme selskapsnavn, adresse og telefonnummer på alle plattformer, ofte kalt NAP: Name, Address, Phone
- Bruk strukturerte data til å beskrive merkevaren og egenskapene dens tydelig
- Koble innholdet til etablerte entiteter, som bransjebegreper, kjente verktøy og navngitte rammeverk, slik at AI lettere kan plassere merkevaren i en relevant sammenheng
Steg 6: Publiser egne data og undersøkelser
En av de mest effektive metodene innen LLM seeding er å bli originalkilden til unik informasjon. Når en språkmodell finner en opplysning som bare du kan dokumentere, får den en grunn til å vende tilbake til kilden din. Gjennomfør mindre spørreundersøkelser, analyser egne kundedata eller bestill en studie fra en uavhengig aktør. Presenter resultatene med tydelig informasjon om dato, metode og antall deltakere eller observasjoner. Det gjør opplysningene etterprøvbare og egnet som kilde – to viktige forutsetninger for at AI skal kunne bruke dem i et svar.
De beste plattformene for LLM seeding
Ikke alle innholdskanaler når AI-modeller like effektivt. Prioriter ut fra de to veiene til synlighet: treningsdata og informasjonsinnhenting i sanntid.
Publiseringsplattformer med høy autoritet (LinkedIn, Medium, Substack): Disse gjennomsøkes ofte, har høy domeneautoritet og får nytt innhold raskt indeksert. LinkedIn-artikler er knyttet til ekte fagprofiler, noe som gir språkmodellene et signal om troverdighet. Mediums enkle og tydelige innholdsstruktur er lett for AI å tolke. Substack passer godt for faglige perspektiver og nyhetsbrev, der en tydelig redaksjonell stemme og fordypning i et tema styrker autoriteten.
Bransjepublikasjoner og redaksjonell omtale: Nisjenettsteder med høy autoritet veier tungt når AI leter etter ekspertkilder innen en bestemt bransje. For spesifikke spørsmål kan en omtale i en respektert bransjeblogg gi større gjennomslag enn bred dekning i allmenne medier. Å bli inkludert i anbefalingslister i nyhetsbrev, bloggartikler og kuraterte oversikter er særlig verdifullt. Slike formater er blant dem språkmodeller oftest henviser til.
Anmeldelses- og sammenligningsplattformer (G2, Capterra, Trustpilot): Disse blir ofte sitert når brukere ber AI anbefale verktøy. Plattformene har høy troverdighet fordi de samler erfaringer fra uavhengige brukere. Prioriter utførlige, konkrete anmeldelser fra ekte kunder.
Reddit og Quora: Ifølge Semrush henviser språkmodeller oftere til Reddit enn til noen annen enkeltkilde. Quora er det mest siterte nettstedet i Googles AI Overviews. På begge plattformene fungerer konkrete, faglig solide og godt strukturerte svar best. Bidra med hjelp som løser brukerens problem, og la ekspertisen bygge tilliten.
YouTube: Henvisninger til YouTube i AI-svar økte tydelig gjennom 2025, i takt med at AI-systemene ble bedre til å hente informasjon fra transkripsjoner, undertekster og videobeskrivelser. Optimaliser titler, beskrivelser og undertekster etter de samme prinsippene som skriftlig innhold.
GitHub Discussions: For tekniske merkevarer er diskusjoner på GitHub en sterk, men ofte underutnyttet kanal for LLM seeding. Ved å delta i relevante tråder, besvare spørsmål og bidra med løsninger bygger du troverdighet som AI kan fange opp når utviklere søker hjelp.
Redaksjonelle mikronettsteder: Et eget, redaksjonelt nettsted med fokus på bransjen din kan bli en mer troverdig kilde enn en vanlig bedriftsside. IKEAs forskningsnettsted Life at Home er et godt eksempel. Det publiserer egne data om livet hjemme og trivsel, med en tydelig kobling til merkevaren uten å fungere som en produktkatalog. Gi nettstedet en gjennomarbeidet redaksjonell struktur, presenter forfatterne, oppgi kilder og gjør de redaksjonelle retningslinjene tilgjengelige.
Ditt eget nettsted med teknisk AEO: Her ligger fundamentet. Selv når AI ikke henviser direkte til domenet ditt, styrker et godt strukturert og troverdig nettsted modellens forståelse av merkevaren. Det kan også brukes som kilde når AI henter informasjon via RAG.
Innholdsformater som får AI til å sitere deg
Formatet er like viktig som innholdet. Noen strukturer gjør det enklere for AI å hente ut informasjon, formulere den om og oppgi deg som kilde.
Topplister med tydelig metode er blant formatene som fungerer best for å få kildehenvisninger fra språkmodeller. Men en rangert liste alene er ikke nok. Forklar hvordan du valgte alternativene: testprosessen, kriteriene og vurderingsmetoden. Språkmodeller prioriterer innhold der konklusjonene er åpne og godt begrunnet. Gi hvert alternativ en konkret «best for»-beskrivelse som speiler reelle spørsmål, for eksempel «best for frilansere med stramt budsjett» eller «best for store organisasjoner». AI kan bruke slike formuleringer direkte når svaret tilpasses brukerens situasjon. Følg samme struktur for hvert alternativ: navn, oppsummering, viktigste funksjoner, fordeler og ulemper samt pris.
Produktanmeldelser basert på egne tester og målbare resultater gir AI tre sterke grunner til å bruke innholdet: praktisk erfaring, en metode som kan gjentas, og konkrete konklusjoner. Oppgi hvor mange produkter du testet, hvem som gjennomførte testene, når de ble gjort, og hvilke kriterier du brukte. Skriv korte, tydelige setninger som balanserer styrker og svakheter. «Det er det beste valget for team med færre enn 20 personer, men mangler de avanserte rapporteringsfunksjonene større organisasjoner trenger» er langt enklere for AI å bruke enn et langt avsnitt der konklusjonen er pakket inn.
Spørsmål og svar speiler hvordan brukerne spør AI. Formatet gjør det lett å finne både spørsmålet og svaret. Hver viktig side på nettstedet bør ha et FAQ-avsnitt som tar utgangspunkt i spørsmålene kundene faktisk stiller til AI-tjenester. WordPress-utvidelser som Rank Math og Yoast kan legge til strukturerte data av typen FAQPage, slik at spørsmålene og svarene blir enklere å identifisere maskinelt.
Sammenligningstabeller brukes ofte i svar som skal hjelpe brukeren å ta en beslutning. Gå lenger enn å sammenligne funksjoner. Vis hvilke alternativer som passer best til ulike behov, og hvilke avveininger kunden må gjøre. Formuler konklusjonene så tydelig at AI kan se hvilket alternativ som passer for hvilken bruker.
Nummererte lister og steg-for-steg-guider gjør det enkelt for modeller å følge og gjengi en prosess. En guide med tydelig nummererte steg er lettere å sitere enn løpende tekst som dekker det samme temaet.
Faglige meningsartikler med tydelige konklusjoner kan bli verdifulle kilder når standpunktet er godt underbygget. Et perspektiv som utfordrer etablerte oppfatninger i bransjen, eller en prognose basert på data, gir AI noe særpreget å vise til. Det gjelder særlig når forfatteren er en navngitt ekspert med relevant kompetanse. Bruk tydelige avsnitt og oppsummer hovedpoengene, slik at argumentet er lett å hente ut.
Navngitte eksperter og E-E-A-T-signaler styrker troverdigheten. Presenter forfatterne med en kort biografi, bruk direkte sitater fra navngitte fagpersoner og henvis til konkrete studier. E-E-A-T står for erfaring, ekspertise, autoritet og troverdighet. Innhold som tydelig viser hvem som står bak, og hvilken kompetanse de har, får oftere gjennomslag i AI-svar.
Kundecaser med konkrete resultater blir mer anvendelige som kilder jo mer spesifikke de er. Målbare resultater som «reduserte svartiden fra fire timer til 22 minutter» gir AI tydelige fakta som kan kontrolleres og gjengis.
Verktøy, maler og rammeverk får henvisninger fordi de løser konkrete problemer brukerne stadig søker hjelp med. Når noen spør Perplexity «Hvordan kan jeg sjekke søkeordplasseringene mine gratis?», anbefaler tjenesten bestemte verktøy ved navn. Gi ressursen en beskrivende tittel som samsvarer med brukernes spørsmål. Forklar i innledningen hvem den er laget for, og hvordan den brukes. Legg til vanlige spørsmål eller konkrete brukseksempler, slik at AI forstår både sammenhengen og verdien.
Slik måler du merkevarens synlighet i AI
For å måle resultatene av LLM seeding må du supplere tradisjonell SEO-analyse med nye metoder. Kanalen er fortsatt ung, og målene er mindre standardiserte, men verktøyene og mulighetene utvikler seg raskt.
Signalet i Google Search Console: Flere visninger, færre klikk
Et tidlig tegn på at AI påvirker kjøpsreisen, kan være et bestemt mønster i Google Search Console: Visningene øker samtidig som klikkene faller. En mulig forklaring er at brukeren ser merkevaren din i et AI-svar, legger den på minnet og søker direkte etter deg dager eller uker senere. Det kan gi lavere klikkrate i organiske søkeresultater samtidig som merkevaresøk og direktetrafikk holder seg stabile eller øker. Slik undersøker du mønsteret: Åpne Google Search Console og sammenlign visninger og klikk de siste tre til seks månedene. Se deretter på utviklingen i Google Analytics. Hvis direktetrafikken øker mens de organiske klikkene faller, kan det tyde på at AI bidrar til merkevarekjennskapen. Det kan være et positivt signal som er verdt å undersøke nærmere.
Test AI-spørsmål manuelt – helt gratis
Den mest direkte metoden er å jevnlig stille AI-tjenestene de samme spørsmålene som kundene dine og se om merkevaren dukker opp i svarene. Bruk et privat vindu eller inkognitomodus for å redusere påvirkningen fra personalisering. Test i ChatGPT, Perplexity, Claude og Googles AI Overviews. Den samme merkevaren kan bli sitert i under 1 % av svarene på én plattform og i over 27 % på en annen. Derfor må du følge flere plattformer.
Lag en spørsmålsbank med 20–30 representative spørsmål fra ulike deler av kjøpsreisen. Test dem hver måned og dokumenter:
- Hvilken AI-tjeneste du brukte
- Det nøyaktige spørsmålet
- Om merkevaren din ble nevnt
- Hvor i svaret den dukket opp
- Hvordan merkevaren ble omtalt, og i hvilken sammenheng
- Hvilke konkurrenter som ble nevnt sammen med deg
Dette gir deg et utgangspunkt for å måle utviklingen over tid.
Verktøy for å følge AI-synlighet
Otterly.ai: Følger kildehenvisninger og merkevareomtaler i AI-genererte svar fra ChatGPT, Perplexity og andre tjenester.
Profound AI: En plattform for større virksomheter som følger søkevolum i AI-tjenester, siteringsfrekvens og trafikk fra AI-boter.
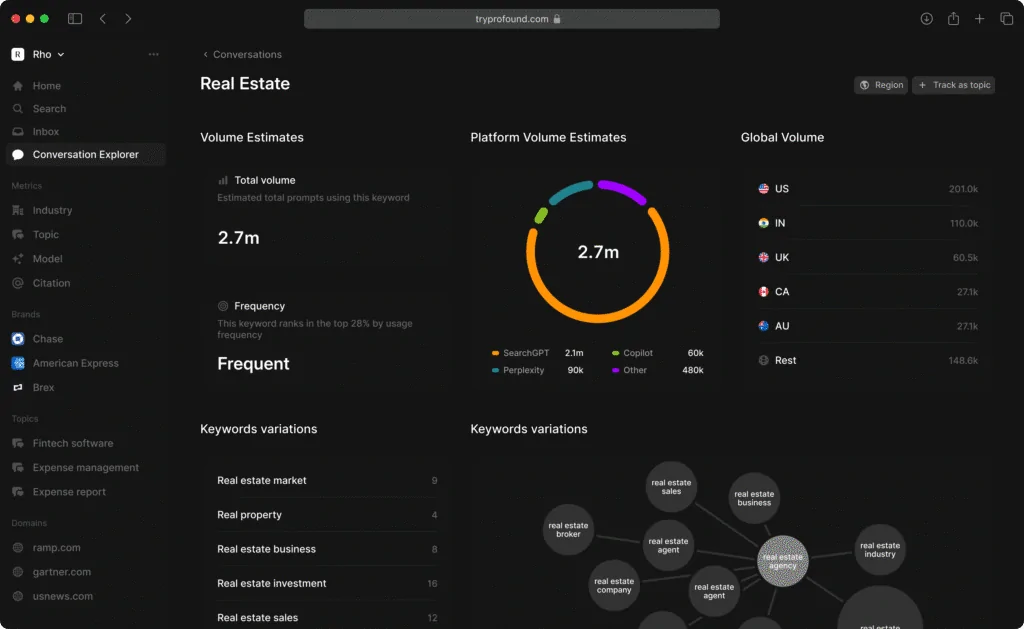
Semrush AI Visibility Toolkit: Et tillegg til eksisterende abonnementer som følger merkevarens synlighet, share of voice og hvordan den omtales i ChatGPT, Perplexity og Google AI Mode. Inkluderer sammenligninger med konkurrenter.
PromptMonitor: Overvåker merkevareomtaler på de største AI-plattformene.
Tilpass webanalysen til AI-trafikk
Sørg for at webanalysen registrerer trafikk fra AI-tjenester riktig. Mange analyseplattformer fører i dag deler av denne trafikken som direktetrafikk. Det betyr at tallene dine sannsynligvis undervurderer antallet besøk fra AI. Opprett egendefinerte kanalgrupper som fanger opp henvisningstrafikk fra ChatGPT, Perplexity, Copilot og Gemini. Følg trafikken separat, og sammenlign konverteringsraten med organisk søk og direktetrafikk.
Fem nøkkeltall du bør følge
Suppler tradisjonelle plasseringer med disse GEO-spesifikke målene:
- Siteringsfrekvens: Hvor ofte merkevaren din dukker opp i AI-svar på spørsmålene du vil være synlig for.
- Merkevaresynlighet: Andelen av de utvalgte spørsmålene der merkevaren din blir nevnt.
- Share of voice i AI: Din andel av alle siteringer og omtaler i kategorien.
- Sentiment: Hvordan AI omtaler merkevaren – positivt, nøytralt eller negativt.
- Konvertering fra AI-trafikk: Hvor mange besøk fra AI som fører til kjøp eller leads, og hvilke inntekter de skaper.
Vanlige fallgruver og realistiske forventninger
Resultatene kan ta lengre tid enn innen SEO. Innhold som skal påvirke modellens treningsbaserte kunnskap, kan trenge flere måneder før det får gjennomslag. Tjenester som henter informasjon i sanntid, som Perplexity, kan gi raskere resultater. Planlegg med en tidshorisont på tre til seks måneder før du forventer stabile endringer i siteringer fra treningsbaserte modeller. LLM seeding ligner merkevarebygging og arbeidet med å etablere en faglig autoritet. Effekten bygges gradvis opp og kan deretter akselerere.
Du kan påvirke sannsynligheten. AI-svar bygger på sannsynligheter og kan variere selv når spørsmålet er identisk. Sjansen for at ChatGPT gir nøyaktig samme liste med merkevarer i to svar på samme spørsmål, er mindre enn én av hundre. Du kan øke sjansen for å bli sitert betydelig, men aldri garantere det. Det finnes ingen enkelt innstilling som sikrer en plass i svaret.
Innsynet i treningsdataene er begrenset. Det er ikke alltid tydelig hvilke kilder en modell legger størst vekt på. LLM seeding må derfor bygge på velbegrunnede strategiske antakelser: at troverdighet, konsistent informasjon, faglig dybde og omtaler fra autoritative tredjeparter øker sannsynligheten for å bli sitert. Prosessen er for lite gjennomsiktig til at den kan kartlegges nøyaktig.
Attribusjon er krevende. En omtale i et AI-svar kan bygge merkevarekjennskap uten å skape et målbart besøk på nettstedet. Verdien er reell, men vises ikke nødvendigvis tydelig i analyseverktøyene. Indirekte mål som flere merkevaresøk, økt direktetrafikk og kvaliteten på salgskvalifiserte leads fra AI kan hjelpe deg å få et mer komplett bilde.
Manipulasjon kan slå tilbake. Fabrikkerte anmeldelser, oppdiktet statistikk og villedende innhold kan skade synligheten etter hvert som modellene blir bedre til å oppdage manipulasjon. Den bærekraftige strategien er å gjøre korrekt, nyttig og godt strukturert informasjon tilgjengelig gjennom troverdige kilder. Det bygger både synlighet og tillit.
Slik gjør du AI-synlighet til inntekter
For å gjøre en AI-omtale til en salgsmulighet må du ta vare på interessen når kunden kommer. Besøkende fra AI konverterer ofte bedre fordi de allerede har fått hjelp til å forstå alternativene og vurdere løsningen din. Nå må nettstedet hjelpe dem videre. Her kan Weply, med ekspertise på leadkonvertering gjennom chat, spille en avgjørende rolle.
I en analyse av 13 måneders data hadde trafikk fra store språkmodeller en konverteringsrate på omtrent 18 %. Det var høyere enn alle andre trafikkilder i analysen, inkludert betalt søk, organisk søk og direktetrafikk. Samtidig vokser AI-trafikken fra et lavt utgangspunkt. Selv en relativt liten økning i siteringsfrekvens kan derfor få stor betydning for inntektene.
I praksis betyr det at besøkende fra AI ofte vurderer et kjøp eller seriøst overveier løsningen din. Tilpass landingssiden til sammenhengen de kommer fra. Hvis AI anbefaler deg for et bestemt bruksområde, bør siden vise med en gang hvordan du dekker det behovet. Bruk relevante handlingsoppfordringer og tilby chat som hjelper kunden med de siste spørsmålene. Ta utgangspunkt i det personen allerede vet, og gjør veien videre enkel. AI bygger kjennskap og sender besøkende med sterk kjøpsintensjon til nettstedet. Chat i sanntid hjelper deg å fange opp interessen mens den er på sitt sterkeste.
Vanlige spørsmål om LLM seeding
Hvor lang tid tar det før LLM seeding gir resultater?
For å påvirke den treningsbaserte kunnskapen i modeller som ChatGPT og Claude bør du regne med tre til seks måneder før innholdet får jevnlig gjennomslag i siteringene. Tjenester som henter informasjon i sanntid, som Perplexity, kan fange opp nytt innhold i løpet av noen dager. Begynn med å følge resultatene i Perplexity for raskere tilbakemeldinger, samtidig som du bygger grunnlaget for langsiktig synlighet i treningsbaserte svar.
Er LLM seeding det samme som SEO eller AEO?
Nei, men de henger sammen. LLM seeding er en konkret metode innenfor AEO, Answer Engine Optimization, som er et bredere fagområde enn tradisjonell SEO. SEO handler om plasseringer og klikk i søkemotorer. AEO handler om å bli en troverdig kilde i ulike typer svar: stemmesøk, fremhevede utdrag, kunnskapspaneler og AI-tjenester. LLM seeding er en av de mest fremtidsrettede delene av AEO. Målet er å påvirke hva store språkmodeller kjenner til og gjengir om merkevaren din, gjennom strategisk plassering av innhold i kildene AI lærer av. Nesten 90 % av ChatGPTs kildehenvisninger går til sider som ligger på plass 21 eller lenger ned i Google. Det viser hvorfor LLM seeding trenger en egen strategi som utfyller tradisjonell SEO.
Fungerer LLM seeding likt i ChatGPT, Claude og Perplexity?
Nei, og forskjellen er viktig. ChatGPT og Claude bruker i større grad kunnskap fra treningen, som er vanskeligere å påvirke i sanntid. Perplexity bygger først og fremst på RAG og henter oppdatert innhold når et spørsmål stilles. Nytt, godt strukturert innhold kan derfor få raskere gjennomslag der. Googles AI Overviews kombinerer begge veiene. En strategi som bygger konsistent tilstedeværelse på nettet og gjør innholdet lett å finne og tolke, øker sjansen for å bli sitert på tvers av plattformene.
Kan små bedrifter konkurrere med store merkevarer om AI-siteringer?
Ja, særlig innen tydelige nisjer. Konsistens betyr mer enn budsjett. En liten bedrift som publiserer konkrete, godt strukturerte svar på spørsmål som mangler gode kilder, får ekte kundeanmeldelser og bidrar med kunnskap i relevante forum, kan få større gjennomslag enn en stor konkurrent med generisk innhold. Finn de spesifikke spørsmålene kundene dine stiller til AI, og bli den beste kilden til svar på dem.
Hvordan retter jeg feilaktig informasjon AI sprer om merkevaren min?
Publiser korrekt og godt dokumentert informasjon på autoritative plattformer. Jo flere troverdige kilder som konsekvent gjengir riktige opplysninger, desto bedre grunnlag får AI-systemene for å bruke dem. Ved viktige rettelser bør du prioritere Wikipedia, hvis det er relevant for merkevaren, større anmeldelsesplattformer og redaksjonell omtale. Disse kildene veier tungt både i treningsdata og når AI henter oppdatert informasjon.
Er LLM seeding etisk?
Ja, når arbeidet handler om å gjøre sann og nyttig informasjon om merkevaren tilgjengelig. Målet er at AI skal kunne finne og kontrollere korrekte opplysninger. Nyttig innhold, autentiske anmeldelser og troverdighet hos uavhengige kilder er grunnlaget for en strategi som både fungerer og holder over tid.